第 7 章 開発工程への組み込み7.7
Cloudflare security-audit-skill の仕組みと監査記録の検証
Cloudflare の security-audit-skill を固定版で読み、6段階の監査と独立検証を解説します。自作 JSON 12ケースで検査プログラムを動かし、形式の検査で止まる誤りと、事実確認が必要な範囲を確かめました。
要点
- security-audit-skill は、AI によるコード監査を調査から報告まで進める手順と、記録の検査プログラムをまとめたスキルです。
- 発見役と検証役を分け、確定した問題と追加確認が必要な候補を別の記録にします。
- 固定版の検査プログラムを自作 JSON 12 ケースで動かすと、深刻度の付け方や検査範囲の記録の誤りを期待どおり拒否しました。
- ただし形式の正しい架空の根拠は通るため、検査の成功は脆弱性が実在する証明にはなりません。
Cloudflare の security-audit-skill は、コーディングエージェントにコード監査の進め方を渡す OSS です。スキルとは、AI が作業するときに参照する手順書と補助ファイルのまとまりです。このスキルでは、怪しいコードを探す作業に加え、根拠を別の AI が確かめる工程を定めています。
特徴は、発見件数だけでなく、調べた範囲と確認できなかった事実を残すことです。利用者が報告を受け取ったときに、修正すべき問題と、環境の確認が必要な候補を区別できます。
公式ソースを固定版で読み、付属する二つの検査プログラムを動かしました。実測したのは監査記録の検査です。AI による完全監査、脆弱性の検出率、実システムへの診断は実施していません。以下では、公式手順の説明と実行結果を分けて扱います。
スキルの構成と利用範囲
このスキルの仕事は、コードから根拠を集め、検証を経た監査記録を作ることです。監査対象は Web API に限りません。CLI、ライブラリ、常駐プログラムなども想定されています。HTTP の入力がない対象に、無理に Web の再現手順を求めない設計です。(Cloudflare、Security Audit・Validation, Structured Output, Verification, and Reporting)
主要なファイルは、役割で分かれています。
| ファイル | 役割 |
|---|---|
SKILL.md | 動作モード、実行の制約、予算、基本原則 |
RECONNAISSANCE.md | 構成と信頼境界の調査、検査範囲の台帳 |
HUNTING.md | 台帳に基づく担当分けと、調査の抜けの確認 |
ATTACK-CLASSES.md と分野別文書 | 調べる問題の分類と対象に応じた観点 |
VALIDATION-AND-REPORTING.md | 候補の検証、記録の再検証、報告の作成 |
report-schema.json | 判定ごとに必要な JSON の項目 |
二つの validate-*.cjs | 記録の形式や項目間の制約を検査するプログラム |
分野別文書には、AI・LLM、ブラウザ、クラウド、供給網などがあります。ただし、名前の似た依存ライブラリがあるだけで選ぶ手順ではありません。事前調査で見つけた境界に応じて、必要な文書を選びます。たとえば LLM がツールを呼ぶ構成なら、その呼び出しで誰の権限を使うかが確認対象になります。(Cloudflare、README・Reconnaissance)
ここでいう信頼境界とは、入力や操作をどの程度信用するかが切り替わる場所です。利用者が指定した ID を、サーバーが管理する所有者情報と照合する箇所が一例です。スキルは、この境界と具体的な影響を説明できない候補を、確定した問題にしない方針を取ります。
導入の手順と二つの動作モード
公式 README は、Skills CLI による次の導入方法を案内しています。このコマンドは公式の導入例であり、今回の実測では実行していません。検証には Git で取得して固定した版を使いました。
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
利用者単位で導入する場合の公式オプションは --global です。エージェントの選択などは Skills CLI のオプションで指定します。導入先のエージェントには、ツール利用と並列サブエージェントの機能が必要です。サブエージェントとは、担当を分けて別の文脈で作業させる AI です。記録の検査には Node.js を使います。(Cloudflare、README)
スキルを読み込むことと、完全監査の開始は別です。確認した版には二つのモードがあります。
| モード | 対象となる依頼 | 作業の範囲 |
|---|---|---|
| guidance | セキュリティの質問、特定の候補の確認 | 関係する手順だけを利用 |
| full audit | コード全体の監査、包括的レビュー、報告成果物の依頼 | 6 段階を実施し、所定の記録を作成 |
今回のようにスキルを説明するために読むだけでは、完全監査を始める理由にはなりません。実際に監査を依頼するときは、許可を得た対象だけを指定します。対象の版、調べるディレクトリ、出力先、予算も依頼に含めると、結果の限界を読み取りやすくなります。
完全監査の標準の出力先は、対象リポジトリの外です。対象内への出力は、利用者が明示的に指定し、バージョン管理で無視されることを確認した場合に限ります。スキルは修正案を報告しますが、監査の工程で対象ソースを変更するものではありません。(Cloudflare、Security Audit)
調査から報告までの六つの段階
公式の手順は、候補を見つけた直後に報告を完成させません。候補を疑う工程と、完成した記録を確認する工程を間に置きます。たとえば所有者確認の欠落を疑った場合でも、呼び出し元ですでに確認していないかを別の担当が調べます。
| 段階 | 主な作業 | 残すもの |
|---|---|---|
| 1 調査 | 構成、入力の入口、権限、実行できる範囲を確認 | 構成の要約と検査範囲の台帳 |
| 2 探索 | 台帳の単位ごとに担当を割り当て、抜けを確認 | 調べたパス、確認方法、候補 |
| 3 候補の検証 | 発見していない担当が反証を試みる | 候補ごとの判定 |
| 4 構造化出力 | 判定を JSON にまとめ、プログラムで検査 | findings.json |
| 5 記録の独立検証 | 最終記録と現在のソースの対応を確認 | 検証済みの記録 |
| 6 報告 | 記録と台帳から読み手向けの文章を作る | 報告書と追加確認の一覧 |
段階 3 の検証役は、発見役の主張をそのまま採用しません。根拠のファイルと行を読み直し、途中の認証や認可が候補を否定しないかを確かめます。再現する場合も、隔離した環境のダミーデータで、必要最小限の結果を確認します。
段階 5 は、候補の発見ではなく、最終記録の点検です。報告文を整理した際に、再現条件が抜けたり、観測した結果より影響が大きく書かれたりしていないかを確認します。判定の引き上げなど重要な変更があれば、さらに別の検証役が必要です。(Cloudflare、Validation, Structured Output, Verification, and Reporting)
報告書も用途ごとに分かれます。REPORT.md は対象範囲と確定した問題、追加確認、調査の限界をまとめます。FINDINGS-DETAIL.md は medium 以上の確定記録の詳細です。NEEDS-VALIDATION.md は未解決の事実と確認計画をまとめます。文章に直す段階で、JSON の判定や深刻度を変えてはいけません。
独立した AI を使う仕組みは、同じ担当による自己確認を避けるためのものです。人間の専門家による監修と同じではありません。独立検証があることだけを根拠に、誤検出がなくなるとは評価できません。
三つの判定と深刻度の扱い
このスキルは、問題の確からしさと、問題が与える影響を分けます。確認できていない候補に「重大」と付けて修正一覧へ混ぜないためです。
| 判定 | 意味 | 主な項目 | 深刻度 |
|---|---|---|---|
confirmed | 根拠の経路と限定された観測結果が揃った問題 | 原因、期待動作、条件、実行結果、修正方針 | 付ける |
needs_validation | ソースに根拠はあるが、決定的な事実が不足 | 仮説、根拠、不足する事実、確認計画 | 付けない |
rejected | 検証によって否定された候補 | 元の主張、根拠、棄却理由 | 付けない |
たとえば、対象の前段にある認証設定がリポジトリにない場合があります。その設定が結論を左右するなら、あるともないとも推定せず、確認すべき事実として残します。これが needs_validation の用途です。単に思いついた懸念の保管場所ではなく、ソースに裏付けられた候補である必要があります。
confirmed では、発生のしやすさと影響を別に説明します。総合の深刻度は、実証した影響を超えてはいけません。防御策が一層不足していても、別の制御が経路を遮断しているなら、直ちに脆弱性として扱いません。(Cloudflare、Security Audit)
もう一つ区別が必要なのは、予算切れで検証役を割り当てられなかった候補です。これは needs_validation へ便宜的に移しません。台帳に未検証の候補として残し、実行全体を未完了とします。「環境の事実が不足している」と「候補の検証をまだしていない」は異なる状態です。
検査範囲の台帳と繰り返し実行
検出がゼロでも、どこまで調べたかが分からなければ結果を評価できません。そこで coverage-ledger.json に、検査範囲を小さな単位で記録します。単位の基本は、入力の入口、信頼境界、サブシステム、問題の分類の組み合わせです。
各単位には、調査対象のパス、担当、確認したパス、確認方法、候補の識別子などを記録します。状態には、未着手の planned、調査済みの covered、候補のある candidate などがあります。対象外は out_of_scope、実施を見送ったものは deferred です。これらを調査済みの件数へ混ぜない仕組みです。(Cloudflare、Reconnaissance)
過去の実行結果も読みますが、前回の判定をそのまま持ち越すわけではありません。関係するコードと条件が変わっていないかを確かめます。同じ原因を示す fingerprint を保ちつつ、現在のソースに対して再検証します。前回の対象外や未解決の範囲は、今回の作業候補になります。
この台帳があることで、「前回と同じ問題を見つけた」だけの反復と、「前回の未調査部分を確認した」実行を区別できます。ただし台帳の状態も AI が書く記録です。内容の正しさは、記録された証拠と合わせて判断します。
実行量の選択と費用の管理
公式のプロファイルは quick、standard、deep の三つです。違うのは調べる細かさと確認の重ね方であり、問題を確定する根拠の基準は共通です。
| プロファイル | 手順上の違い |
|---|---|
quick | 探索を 1 回のまとまりで行い、最後に抜けを確認。候補検証と最終記録検証を一人の独立した検証役が担当 |
standard | 標準の工程で進め、候補検証と最終記録検証を別の担当が実施 |
deep | サブシステムや状態変化ごとに細分化し、過去に調査済みの同一ソースにも独立した再確認を追加 |
quick や対象を絞った実行は、部分的な検査であると報告します。速い設定でも、独立検証を省略してよいわけではありません。(Cloudflare、Security Audit)
予算はエージェントの呼び出し回数として記録します。調査役だけで使い切らず、抜けを点検する担当と検証役の分を先に確保します。ただし呼び出し回数は、そのまま金額ではありません。モデル、入力の長さ、再検証の回数などを別に計測する必要があります。
今回の検証はモデルを呼ばないため、追加の API・クラウド実費は 0 USD でした。これは完全監査の費用を示す数値ではありません。完全監査の所要時間や費用は今回測っていません。
対象コードの実行を制限する仕組み
監査対象には、ビルドやテストの実行だけで動くコードも含まれます。そのため公式手順は、対象コードを動かす際に OS が強制する隔離を要求します。「外部へ接続しないように」と AI に文章で指示するだけでは、この要件を満たしません。
主な条件は、外部ネットワークの遮断、許可した値だけの環境変数、対象とツールの読み取り専用化です。書き込みは割り当てた一時領域に限定し、CPU やメモリ、実行時間などにも上限を設けます。条件を満たせなければ対象コードを実行せず、不足する能力を検証の障害として記録します。(Cloudflare、Security Audit)
保存する証拠にも制限があります。対象コードが書いたファイルを、そのまま報告用の領域へ一括コピーしません。親役側の処理が、事前に決めた通常ファイルだけを、リンクやサイズなどを確認して移します。調査対象が作るファイルを、信頼した成果物として無条件に扱わない設計です。
スキルの導入コマンドだけで、これらの隔離機能が用意されるとは説明されていません。実行環境が要件を満たすかは別途確認が必要です。今回の実測は、自作 JSON を検査プログラムへ渡す作業であり、この完全監査用の隔離環境を構築したものではありません。
今回の検証の条件
検証の目的は、判定記録と台帳に対して、検査プログラムが何を拒否するかを確かめることです。公式リポジトリの commit c1c8a8c1471069fb0e188eeaff69b8e8db6564a8 に固定しました。
| 項目 | 条件 |
|---|---|
| 実行日 | 2026 年 11 月 5 日 |
| 環境 | macOS 26.7.2、arm64、Node.js v22.23.4 |
| 入力 | 自作の架空 JSON。監査記録 9 ケースと台帳 3 ケース |
| 実行したもの | validate-findings.cjs、validate-coverage-ledger.cjs |
| 終了値の記録 | 標準出力、標準エラー、終了コードを各ケースで保存 |
| 実施していないもの | モデルの呼び出し、候補の探索、対象コードの実行、実環境への通信 |
confirmed の入力も架空です。ファイル名や観測結果の文章は、形式を検査するために自作しました。実在の脆弱性を報告しているものではありません。
検証の手順
正しい形式の記録を基準にして、一つずつ条件を崩します。こうすると、どの制約が検査されるかを比較できます。
- 公式リポジトリを使い捨てのディレクトリへ取得し、対象の commit に固定しました。
- 三つの判定と、未着手の台帳について、自作 JSON を用意しました。
- 深刻度の追加、必須項目の削除、識別子の重複などの変更版を作りました。
- 各入力を CLI に渡し、期待する終了コードと実際の終了コードを比較しました。
- 元の出力を保存し、サイト共通の端末描画処理で画像にしました。
CLI の呼び出し方は次の形です。SKILL_DIR は固定したスキルのディレクトリを指します。入力ファイルは自作の検査データです。
node "$SKILL_DIR/validate-findings.cjs" findings.json
node "$SKILL_DIR/validate-coverage-ledger.cjs" coverage-ledger.json
各起動には 5 秒の待ち時間上限を設定しました。検査プログラムに渡す環境変数は、Node.js のディレクトリを指す PATH だけです。試験用スクリプトが入力を保存し、検査プログラムがそれを読み込みます。第三者の対象プログラムは実行しません。
検証の結果
12 ケースすべてで、終了コードは期待どおりでした。形式の正しい 4 ケースは終了コード 0、不正な 8 ケースは 1 になりました。表の「通過」は記録の検査を通った意味です。
| 入力 | 期待 | 実測 |
|---|---|---|
confirmed の形式を満たす架空記録 | 通過 | 0 |
needs_validation の形式を満たす架空記録 | 通過 | 0 |
rejected の形式を満たす架空記録 | 通過 | 0 |
needs_validation に深刻度を追加 | 拒否 | 1 |
confirmed から観測結果を削除 | 拒否 | 1 |
| 実証した影響より総合の深刻度を高く設定 | 拒否 | 1 |
| 根拠のパスを絶対パスに変更 | 拒否 | 1 |
同じ fingerprint の記録を二重に投入 | 拒否 | 1 |
| 追加確認の計画を空に変更 | 拒否 | 1 |
| 未着手の台帳を投入 | 通過 | 0 |
証拠なしで台帳を covered に変更 | 拒否 | 1 |
| 同じ検査単位の ID を二重に投入 | 拒否 | 1 |
図 7.7.1 監査記録の検査結果は、この比較を行った端末の出力です。各行の PASS は期待した終了値と一致したことを示します。不正な入力でも、期待どおり拒否されれば PASS と表示されます。
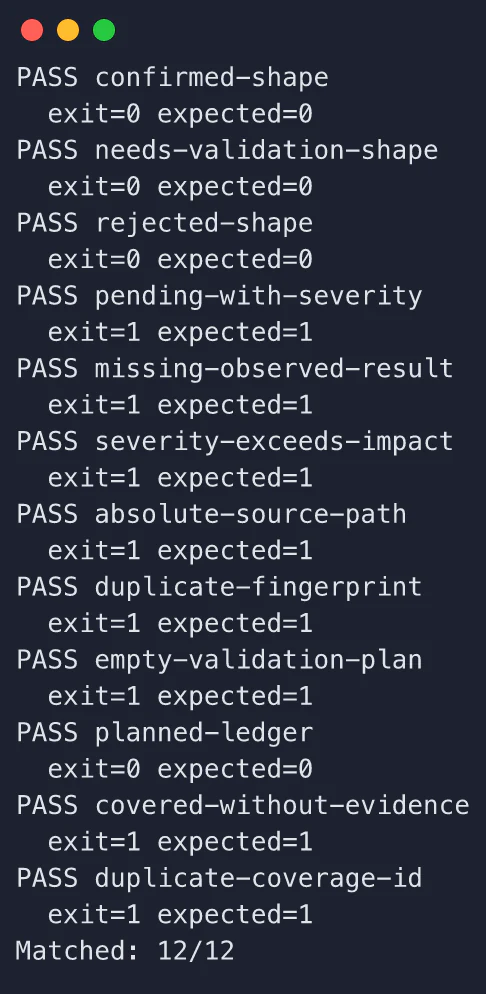
この結果は、検査プログラムが判定の混同を防ぐ助けになることを示します。特に、未検証の候補に深刻度を付ける変更と、証拠のない調査済み状態を拒否した点は、報告を過大に見せないために役立ちます。
一方で、形式の正しい架空の記録は通過しました。検査プログラムは、書かれた根拠を読んで実在性を判定する監査担当ではありません。今回の入力には実際に確認したソースも再現結果もありません。それでも必要な形の文章が入っていれば、形式の検査は通ります。
公式文書も、検査の成功が示すのは形式と台帳の整合性であると明記しています。したがって、JSON の検査と AI による独立検証は役割が異なります。さらに今回の 12 ケースだけで、検査プログラム自体の完全性を証明したわけでもありません。
つまずきと導入時の判断
最も混同しやすいのは、記録の検査の成功を、監査そのものの成功と読むことです。今回も架空の confirmed が通りました。運用で受け取る際は、終了コードだけでなく、引用されたソース、条件、観測結果を確認する必要があります。
もう一つは、quick を「検証を省いた簡易版」と解釈することです。公式手順では、発見役から独立した検証役を残します。費用を抑えるには、証拠の基準を下げるのではなく、対象範囲や調査の粒度を選ぶ設計になっています。
導入判断では、次の三つを分けて確認すると結果を評価しやすくなります。
- エージェントが手順を実行できるか。担当の分離や呼び出し回数の管理を含みます。
- 実行環境が対象コードを隔離できるか。スキルの文章とは別に強制できる必要があります。
- 報告から根拠へ戻れるか。現在のソースと観測結果の対応を確認します。
今回確認できた価値は、AI の監査を、後から点検できる記録へ整理する設計です。発見役、検証役、形式検査、範囲の台帳を組み合わせています。自社コードでの検出性能や、独立検証による誤検出の減少幅は未測定です。実運用への評価には、既知の正解を持つ自作対象での完全監査を別に行う必要があります。
自社での取り組みについて相談する
AI システムの権限・承認設計やセキュリティ対策について、株式会社UNIQUEX にご相談いただけます。
記事のタイトルと URL をお問い合わせフォームへ引き継ぎます。実現したいこと・困っていることをお書きください。
UNIQUEX に相談する