第 4 章 採点4.3
自動採点と人手採点の一致度の検証
架空の規程の問答 40 件に正解のラベルを付け、gemini-2.5-flash-lite とローカルの Gemma 4(e2b)で採点して、一致率・Cohen の κ・見逃しの内訳を、採点の指示を 3 通りに変えて測った記録です。
要点
- 架空の出張旅費規程の問答 40 件(合格 17・不合格 23)を、規程の正しい答えを渡して採点させると、gemini-2.5-flash-lite は 40 件中 37 件が正解のラベルと一致し(Cohen の κ 0.85)、ローカルの gemma4:e2b は 29 件(κ 0.46)でした。
- gemma4:e2b の外れ 11 件のうち 8 件は、条件を書き落とした不合格の回答を合格にした見逃しで、そのうち 7 件が条件の欠落でした。
- 正しい答えを渡さないと、gemini-2.5-flash-lite は 17 件の合格のうち 16 件を不合格にし(κ 0.07)、gemma4:e2b は κ が -0.17 でした。
- 要点を箇条書きにして 1 つずつ確かめさせる指示は、どちらのモデルでも一致を下げ、gemini-2.5-flash-lite では 40 件中 5 件で JSON の後に文字が続いて判定を読めませんでした。
- 温度 0 では 3 回とも判定が同じで、くり返しても採点の誤りは見えません。
- ラベルは回答を作ったときに決めた正解で、別の人が独立に採点した値ではありません。
定義
- 採点の一致度
- 同じ対象を同じ基準で採点したときに、判定がどの程度そろうかを表します。
- 一致率(observed agreement)
- 判定が一致した件数を、比較した全件数で割った値です。
- Cohen の κ
- 2 つの判定の一致率から、それぞれの判定の偏りだけで偶然にそろう割合を差し引いて、1 から -1 の値にした指標です。1 は全件の一致、0 は偶然と同じ程度の一致です。
- 見逃し
- この記録では、正解のラベルが不合格である回答に対して、自動採点が合格と判定したことを指します。
LLM 採点(言語モデルに回答と基準を渡して合否を判定させる採点)を使う前に、人が付けた判定とどれだけそろうかを確かめます。この記録では、架空の会社の出張旅費規程についての問答を 40 件作り、それぞれに正解のラベル(合格・不合格)を付けて、2 つの採点モデルに採点させました。採点の指示は 3 通りに変え、一致率、Cohen の κ、どの種類の回答で外れたかを数えています。
LLM 採点の入力や偏りの仕組みは 4.2 に、採点の基準の作り方は 評価データと採点基準 にあります。ここでは「この採点モデルとこの指示で、この 40 件をどれだけ正しく採点できたか」だけを扱います。
検証の条件
規程は架空で、日帰りの日当、宿泊費の上限、精算の期限、タクシー、グリーン車、海外出張、仮払い、私用の延泊の 8 問です。1 問に 5 件ずつ回答を作り、計 40 件(合格 17・不合格 23)にしました。合格の条件は「規程の要点(条件・数値・承認者・例外)をすべて誤りなく含み、規程に無い規則を足していない」です。
不合格の回答は、間違いの作り方を決めて作りました。条件の欠落(「日当は 2,000 円です」のように距離の条件を落とす)、数値の誤り、規程に無い規則の追加、承認者の誤り、営業日と日の取り違えなどです。合格の回答にも、言い換え、自信のない言い方、長い説明、要点だけの短い答え、否定の形を混ぜています。
正解のラベルは、回答を作るときに UNIQUEX の編集(AI)が決めたものです。別の人が独立に採点した値ではありません。そのため、この記録の「一致」は、採点モデルが作り手の意図した判定をどれだけ再現したかを表します。人同士の採点のばらつきは測っていません。
| 採点モデル | 実行した場所 | 設定 |
|---|---|---|
| gemini-2.5-flash-lite | Gemini API(有料枠) | JSON の応答(responseMimeType: application/json)、温度 0。出力の上限は要点の表の指示だけ 1,024 トークン(下の「つまずき」) |
| gemma4:e2b | 手元の Ollama | format: json、温度 0、思考なし |
採点の指示は次の 3 通りです。どれも最後に {"verdict": "pass" または "fail", "reason": "…"} の JSON だけを返すよう求めました。
| 指示 | 渡したもの |
|---|---|
| 参照あり | 合格の条件、規程の該当箇所(正しい答え)、質問、回答 |
| 参照なし | 合格の条件、質問、回答(規程の本文は渡さない) |
| 要点の表 | 参照ありの正しい答えを要点ごとの箇条書きにし、1 つずつ確かめてから判定させる |
手順
data/make_items.pyで 40 件の回答と正解のラベルを書き出す。judge.pyで、2 つの採点モデル × 3 通りの指示を、それぞれ 3 回採点する(採点は計 720 回)。Gemini API の鍵は環境変数だけで渡し、記録には残さない。score.pyで、回ごとの一致率、Cohen の κ、混同行列(正解と判定の組み合わせの表)、回によって判定が変わった件数、外れた回答の種類(作り方)を出す。
Cohen の κ は、一致率から、偶然にそろう割合(それぞれが合格を何割出したかから計算する)を差し引いた値です。合格が少ない集合で何でも不合格にする採点は一致率が高く出るので、κ も並べました。一致率と、偶然の一致を考える指標の違いは Artstein と Poesio が整理しています(2.3〜2.4 節)。
指示ごとの一致の結果
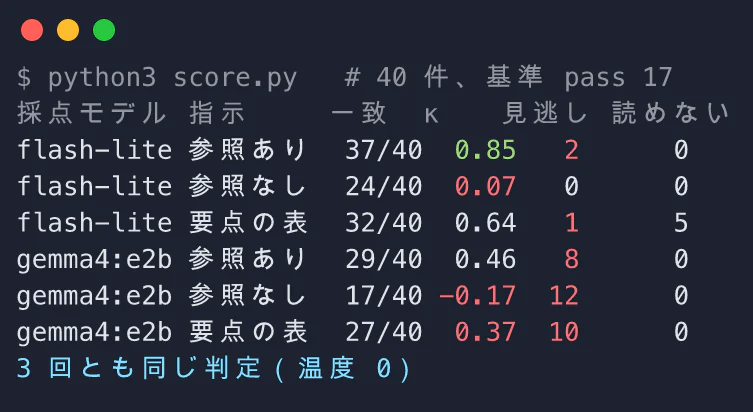
図 4.3.1 採点モデルと指示ごとの一致率と κ は、score.py の結果を 1 行ずつにまとめた画面です。「見逃し」は不合格の回答を合格にした件数、「読めない」は応答から判定を取り出せなかった件数です。
| 採点モデル | 指示 | 一致 | κ | 見逃し | 合格を不合格にした件数 | 読めない |
|---|---|---|---|---|---|---|
| gemini-2.5-flash-lite | 参照あり | 37/40 | 0.85 | 2 | 1 | 0 |
| gemini-2.5-flash-lite | 参照なし | 24/40 | 0.07 | 0 | 16 | 0 |
| gemini-2.5-flash-lite | 要点の表 | 32/40 | 0.64 | 1 | 2 | 5 |
| gemma4:e2b | 参照あり | 29/40 | 0.46 | 8 | 3 | 0 |
| gemma4:e2b | 参照なし | 17/40 | -0.17 | 12 | 11 | 0 |
| gemma4:e2b | 要点の表 | 27/40 | 0.37 | 10 | 3 | 0 |
いちばん一致したのは、gemini-2.5-flash-lite に正しい答えを渡した採点で、外れは 3 件でした。不合格の条件の欠落(タクシーの回答で「領収書と理由を添える」を落としたもの)と、営業日と日の取り違え(「出発の 5 日前まで」)を合格にし、「おそらく」「はずです」と書いた合格の回答を不合格にしました。合格の条件に「自信のない言い方は判定に使わない」と書いていても、理由には「自信のない表現が含まれているため」と書かれていました。
営業日と日の取り違えを合格にした採点の理由は「出発の 5 営業日前までに申請するという規程の要点をすべて含んで」いる、というものでした。回答には「5 日前」と書いてあり、理由が回答の文を取り違えています。理由が書かれていても、判定が正しいとは限りません。
小さいモデルの見逃しの結果
gemma4:e2b に正しい答えを渡した採点では、外れが 11 件あり、そのうち 8 件が見逃しでした。8 件の内訳は、条件の欠落が 7 件、規程と矛盾する回答が 1 件です。
- 「日帰り出張の日当は 2,000 円です」(50km の条件の欠落)を、「規程の要点である 50km 以上の日帰り出張に対する日当 2,000 円を正確に含んで」いるとして合格にした。
- 「出張の終了日から 14 日以内に申請します」(期限後は部長の承認が要ることの欠落)を合格にした。
- 「期限を過ぎた申請は受け付けません」(規程は部長の承認で受け付ける)を合格にした。
数値の誤りや規程に無い規則の追加は、この採点ではすべて不合格にできていました。gemma4:e2b は、書かれた数値の誤りには気づけても、書かれていない条件の欠落には気づきにくいという結果でした。逆に、「2 週間以内」「1 か月前まで」と言い換えた合格の回答を、規程と一致しないとして不合格にしました。なお「1 か月前」は 30 日と同じではないので、この回答を合格とした正解のラベルにも議論の余地があります。
正しい答えを渡さない採点の結果
規程の本文を渡さないと、gemini-2.5-flash-lite は合格の 17 件のうち 16 件を不合格にしました。理由の多くは「承認者や例外に関する情報が含まれていない」というものでした。合格の条件に例として並べた「条件・数値・承認者・例外」を、どの質問にも 4 つすべてが要るという意味に解釈したとみられます。日当の金額を書いた回答に対して、判定理由に「日当の金額が記載されていません」と記した例もありました。不合格はすべて当たっているので一致は 24/40 ですが、κ は 0.07 で、ほぼ何でも不合格にしているだけです。gemma4:e2b は合格と不合格をほぼ半々に出し、κ は -0.17 と、偶然より悪い一致でした。
規程のように採点モデルが知らない内容を採点させるときは、判定の材料(正しい答えや該当箇所)を指示に入れないと、採点として成り立ちませんでした。
要点の表にした指示の結果
正しい答えを要点ごとの箇条書きにし、要点を 1 つずつ確かめてから判定させると、どちらのモデルも一致が下がりました(gemini-2.5-flash-lite は 37 から 32、gemma4:e2b は 29 から 27)。gemma4:e2b の見逃しは 8 件から 10 件に増え、要点を「見つかった」と判定したうえで合格にしていました。
この記録では、要点の分け方を「。」で区切る機械的な方法にしたので、海外出張の「30 日前までに申請し、社長の承認を得る」が 1 つの要点のままでした。承認者を書かなかった回答でも、この要点は「見つかった」と判定され、合格になりました。要点の分け方を人が直せば結果は変わるかもしれませんが、この記録では確かめていません。
つまずき
JSON の応答を指定しても、JSON の後に文字が続いた。 gemini-2.5-flash-lite に要点の表の指示で採点させると、40 件中 5 件で、閉じた JSON の後に "reason": "…"} などの文字が続き、json.loads が失敗しました。うち 1 件は同じ文「していません。"}」を止まらずにくり返し、出力の上限(maxOutputTokens 1,024)で切れました(finishReason: MAX_TOKENS)。上限を付ける前は、この 1 件で 300 秒たっても応答が返らず、採点の実行が時間切れで止まりました。3 回の採点で、同じ 5 件が同じように読めませんでした。
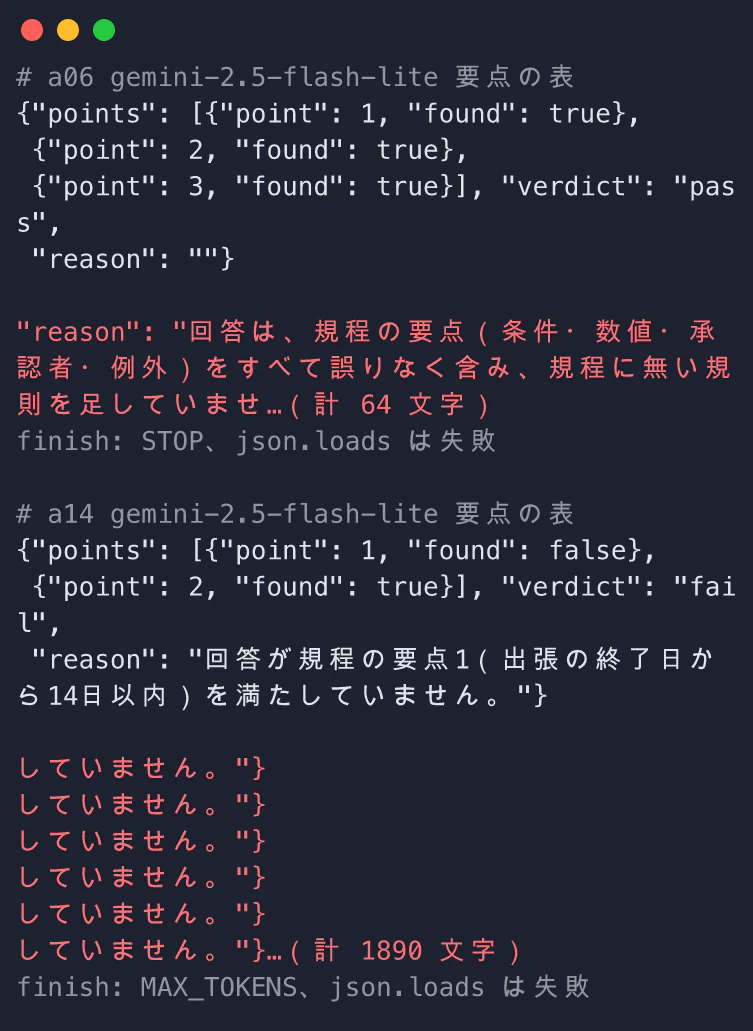
図 4.3.2 JSON の後に文字が続いて読めなかった応答は、読めなかった 2 件の応答の画面です。赤い部分が閉じた JSON の後に続いた文字です。先頭の JSON だけを読めば判定は取り出せますが、この記録では読めない応答として数えました。応答の形を検査する方法は 6.4 にあります。採点の結果を集計に入れる前に、読めなかった件数を必ず数えます。
温度 0 でくり返しても、誤りは見つからなかった。 どの組み合わせも、3 回の採点で判定が変わった回答は 0 件でした。同じ誤りが毎回出るので、くり返して一致を見ても、採点が正しいかは分かりません。正解のラベルと比べて初めて、見逃しの 8 件が確認できました。
正解のラベルの側にも迷う回答があった。 「1 か月前まで」を 30 日前と同じとみなすか、「グリーン車は役員に限られます」だけで一般社員の扱いまで答えたとみなすかは、ラベルを付けた時点で決めた解釈です。採点モデルと食い違った回答は、採点モデルの誤りか、ラベルの解釈の違いかを、規程に戻って切り分けます。
読めなかった応答も結果の一部として件数を記録します。判定を取り出せたら正解ラベルと照合し、不一致なら規程に戻って採点の誤りとラベルの解釈を切り分けます。同じ判定が繰り返し返ることと、その判定が正しいことは別です(図 4.3.3 採点結果を集計し切り分ける流れ)。
費用と所要時間
gemini-2.5-flash-lite の採点 360 回の費用は約 0.016 USD でした(入力 73,248・出力 21,042 トークン、有料枠の単価 100 万トークンあたり入力 0.10 USD・出力 0.40 USD で計算)。採点 1 回の応答の時間の中央値は、gemini-2.5-flash-lite が 815〜865 ms、gemma4:e2b が 1,047〜5,059 ms でした。gemma4:e2b の時間は、ほかの処理で手元の機械の負荷が高い状態で測った値で、負荷の低い機械では短くなります。
保存済みの件数から κ を確かめる
これは新しい採点の実行ではなく、保存済みの第1回の出力からの再計算です。gemini の参照ありでは、基準ラベルが合格17件・不合格23件、モデルの判定が合格18件・不合格22件でした。一致した割合は37÷40=0.925です。各々の合格・不合格の割合だけから計算する偶然の一致は、(17×18+23×22)÷40²=0.5075 となります。したがって κ=(0.925−0.5075)÷(1−0.5075)=約0.848 で、表の0.85と一致します。
「要点の表」の読めない5件は、集計スクリプトで unreadable という別の判定として残しています。一致率の分母40から除かず、基準に同じラベルがないため不一致です。κにもこの区分を含め、偶然の一致は (17×14+23×21)÷40²=0.450625、κは (0.8−0.450625)÷(1−0.450625)=約0.636 になります。読めた35件だけの成績ではありません。
採用判断では、κの値に加えて、不合格を合格にした2件の内容を確認します。見逃した2件(タクシーの「領収書と理由を添える」の欠落と、営業日と日の取り違え)と同じ種類の誤りを含み、調整に使っていない回答で確かめることが次の試験です。この記録だけから、別の業務にも同じ一致率が得られるとは判断できません。
この記録から言えること
- 採点モデルが知らない内容の採点には、正しい答えや該当箇所を指示に入れる。入れないと、何でも不合格にする(κ 0.07)か、偶然より悪い一致(κ -0.17)になった。
- 一致率だけでなく、見逃しの件数と、外れた回答の種類を見る。gemma4:e2b の外れ 11 件は、条件の欠落の見逃しに偏っていた。
- 指示を細かくすれば一致が上がるとは限らない。この 40 件では、要点を 1 つずつ確かめる指示は、どちらのモデルでも一致を下げた。
- 応答から判定を取り出せなかった件数を、一致率と別に数える。
Anthropic も、採点モデルを人の判定と照合して調整し、採点の記録を読んで、実際の失敗と採点の誤りを分けることを勧めています(Step 5、Step 6)。40 件・1 つの規程・作り手のラベルという小さな条件での結果なので、別の課題や採点モデルにそのまま当てはまるとは限りません。採点を変えたら、同じ 40 件と、調整に使っていない別の回答で比べ直します。
自社での取り組みについて相談する
AI エージェントの評価方法や品質の確認について、株式会社UNIQUEX にご相談いただけます。
記事のタイトルと URL をお問い合わせフォームへ引き継ぎます。実現したいこと・困っていることをお書きください。
UNIQUEX に相談する