第 1 章 評価の基礎1.6
評価に使う OSS の役割と選び方
promptfoo・Inspect AI・DeepEval・Ragas・OpenAI Evals が、AI エージェントの評価のどの部分を受け持つかを整理し、確かめたいことや開発の段階に応じた選定基準を表にまとめます。
要点
- 評価に使う OSS は、評価ケースを流してエージェントを動かす部分、結果を採点する部分、記録を読み比べる部分のどれを受け持つかで役割が分かれます。
- promptfoo と DeepEval は設定やテストの形で合否を CI に渡しやすく、Inspect AI はエージェントを動かす仕組みとサンプルごとの記録を読む画面を備え、Ragas は RAG やツール呼び出しを測る指標を提供します。
- OpenAI Evals は PyPI の配布版が 2024 年 5 月から更新されておらず、新しく採用するなら必要な機能と保守の状況を先に確かめます。
- どの道具でも、値や操作の一致はルールで判定し、文章の意味は LLM で採点します。
- LLM の採点は、ルールの結果や人の判定と突き合わせてから信頼します。
定義
- 評価の OSS
- 評価ケースの管理、エージェントの呼び出し、採点、記録をまとめて行う、公開されたソースコードの道具です。
- 決定的な採点
- 同じ回答には毎回同じ判定を返す採点で、値の一致や呼んだツールの名前の確認などをプログラムで行います。
AI エージェントの評価を始めると、評価ケースを何件も流し、回答を採点し、前回と比べる作業を毎回くり返すことになります。評価の OSS とは、この作業をまとめて受け持つ、ソースコードが公開された道具です。たとえば、社内の規程について答えるアシスタントに「海外出張のホテルの上限は」と聞き、回答に 25,000 円が含まれるか、規程のファイルを読むツールを呼んだかを、20 件まとめて確かめます。
道具はどれも「評価ができる」と説明されていますが、受け持つ範囲はかなり違います。この記事では、promptfoo・Inspect AI・DeepEval・Ragas・OpenAI Evals の 5 つについて、評価のどの部分を受け持つか、何を確かめるのに向くか、開発のどの段階に置くかを整理します。5 つを同じエージェントで実際に動かした数字は、6.4 評価の OSS を同じエージェントで比べた結果 にまとめています。
評価の OSS が受け持つ部分
評価の作業は、評価ケース(依頼と期待値の組)の管理、エージェントの呼び出し(回答と途中の操作を受け取る)、採点、結果の記録と比較の 4 つに分けられます。道具の違いは、この 4 つのどこを設定だけで済ませられるかに表れます。採点には、プログラムで判定するルールの採点と、言語モデルに判定させる LLM の採点があります。
| 道具 | ケースの管理 | エージェントの呼び出し | 採点 | 記録と比較 |
|---|---|---|---|---|
| promptfoo | YAML の設定と外部ファイル(今回は JSON) | HTTP の呼び出し先などを設定で指定 | 文字列や JavaScript の判定と、LLM の採点(llm-rubric) | 表・JSON・HTML・JUnit で出力 |
| Inspect AI | Python のデータセット | solver(エージェントの動かし方)を Python で組む | 文字列の採点と、モデルによる採点(model_graded_qa など) | サンプルごとの記録を残し、閲覧の画面と VS Code の拡張で読む |
| DeepEval | pytest のテストとして書く | テストの中で自分で呼ぶ | G-Eval(LLM の採点)、ツール呼び出しの正しさの指標など | pytest の結果と端末の表 |
| Ragas | 評価用のデータの形にそろえる | 持たない(回答は自分で集める) | 忠実度などの RAG の指標、ツール呼び出しの正確さなどエージェント向けの指標 | 指標の値の表 |
| OpenAI Evals | レジストリの YAML と JSONL | OpenAI 以外は自作のクラスが必要 | 文字列一致と、モデルによる分類の採点 | イベントの記録(JSONL) |
この表は、各道具の公式ドキュメントの記載と、2026 年 10 月 16 日に手元で動かして確かめた範囲に基づいて書いています。どの道具でも自作のコードを足せば多くのことができるため、「できる・できない」より、「設定だけで済むか、コードを書くか」の違いとして読んでください。
確かめたいことと道具の機能の対応
評価で確かめたいことは、エージェントの種類と目的によって変わります(2.2)。ここでは、よく出てくる確かめたいことについて、採点の方法と、道具に用意されている機能を対応させます。
| 確かめたいこと | 採点の方法 | 道具に用意されている機能の例 |
|---|---|---|
| 能力(新しくできるようにしたいこと) | 最終的な回答や状態の一致をルールで、文章の質を LLM で | どの道具でも、ケースと判定を書けば測れる |
| 回帰(以前できたことが崩れていないか) | 前回と同じケースを流し、件ごとの合否の入れ替わりを見る | promptfoo の複数の呼び出し先の並列表示、DeepEval の pytest の結果、Inspect AI のサンプルごとの記録 |
| ツール呼び出し | 呼んだツールの名前・引数・順序をルールで | DeepEval の Tool Correctness、Ragas の Tool Call Accuracy、promptfoo と Inspect AI は記録を受け取って自作の判定を適用 |
| RAG(回答が検索した文書に沿っているか) | 回答の主張が文書で裏づけられるかを LLM で | Ragas の Faithfulness |
| RAG(必要な情報を検索できたか) | 参照の回答に必要な情報が、検索した文書に含まれるかを LLM で | Ragas の Context Recall |
| 多段のタスク | 途中の操作と最後の状態を分けて採点 | Inspect AI の solver とツール・隔離環境、Ragas の Agent Goal Accuracy |
| 文章の意味や断り方 | 基準の文を渡して LLM で | promptfoo の llm-rubric、Inspect AI の model_graded_qa、DeepEval の G-Eval、Ragas の AspectCritic |
最終状態・経路・一手のどの粒度で採点するかは、2.1 で扱っています。能力評価と回帰評価の使い分けは 1.3 が詳しく、ここでは道具の機能との対応だけを示しました。
開発の段階ごとの置き場所
同じ道具でも、開発中・CI・本番のどこに置くかで、求められる性質が変わります。開発中は、少ない件数を何度も流すので、失敗した回答と途中の操作をすぐ確かめられる機能が役に立ちます。CI では、不合格を終了コードで伝え、どの件が落ちたかを記録に残す機能が要ります。本番では、利用者の実際の依頼から失敗を拾い、評価ケースに戻すことが中心になります。
- 開発中。 Inspect AI はサンプルごとの記録を画面で読めるため、多段のエージェントの失敗を追うのに向きます。promptfoo も結果の表を画面で比べられます。
- CI。 2026 年 10 月 16 日の実行では、失敗した件があると promptfoo は終了コード 100、DeepEval は 1 で終わり、そのまま CI の合否にできました。Inspect AI・Ragas・OpenAI Evals は終了コード 0 のままで、記録を読んで合否を決める手順を別に足す必要がありました。CI への組み込みの手順は 6.1 にあります。
- 本番。 この記事の 5 つは、決まったケースを流すオフラインの評価で動かしました。本番で何を監視するかは 7.1 で扱います。本番の失敗を評価ケースに加えれば、同じ道具で回帰評価として回せます。
状況ごとの選び方
選ぶときは、最初に「ルールで判定できる条件がどれだけあるか」を考えます。冒頭の規程アシスタントなら、20件の期待値を「回答に期待値を含むか」「規程を読むツールを呼んだか」「社外宛ての送信をしていないか」「断り方の意味」に分け、ルールで判定できない件だけを LLM の採点と人の判定で比べます。同じ回答と操作の記録に同じルールを当てれば、採点の結果を再現でき、LLM の採点の揺れに左右されません。この判断の順番を「図 1.6.1 評価の OSS を選ぶときの分かれ道」に示します。
値やツール呼び出しで判定できることは、ルールの採点として書きます。文章の意味を見るなら LLM の採点を足し、ルールの判定と突き合わせます。そのうえで、不合格のときに CI を止めたいなら失敗時に終了コードを返す道具を、記録を深く読みたいなら Inspect AI に合否を決める手順を足して使います。検索した文書が回答の根拠なら、Ragas の指標を組み合わせます。
| 状況 | 候補 | 理由 |
|---|---|---|
| 設定ファイルで評価を管理し、CI で止めたい | promptfoo | ケース・呼び出し先・判定を YAML にまとめられる。今回の設定では不合格時に終了コード 100 を返します |
| Python のテストとして書き、チームが pytest に慣れている | DeepEval | テストの形で書け、今回の実行では不合格時に終了コード 1。ツール呼び出しの指標がある |
| 多段のエージェントを隔離した環境で動かし、記録を読み込みたい | Inspect AI | solver・ツール・隔離環境の仕組みと、サンプルごとの記録がある。今回の実行方法では CI の合否の判定を別に足した |
| 検索した文書に沿った回答かを数値で見たい | Ragas(他の道具と組み合わせる) | 忠実度などの指標がそろう。今回はエージェントの呼び出しと CI の合否判定を自作のスクリプトで追加した |
| 過去に OpenAI Evals で作った評価がある | OpenAI Evals | PyPI の配布版は 2024 年 5 月以降更新されていない。今回は OpenAI 以外のモデルを呼ぶ自作のクラスが必要でした |
1 つに決める必要はありません。たとえば、CI のルールの採点は promptfoo で回し、検索の品質の確認にだけ Ragas の指標を使う、という組み合わせもできます。
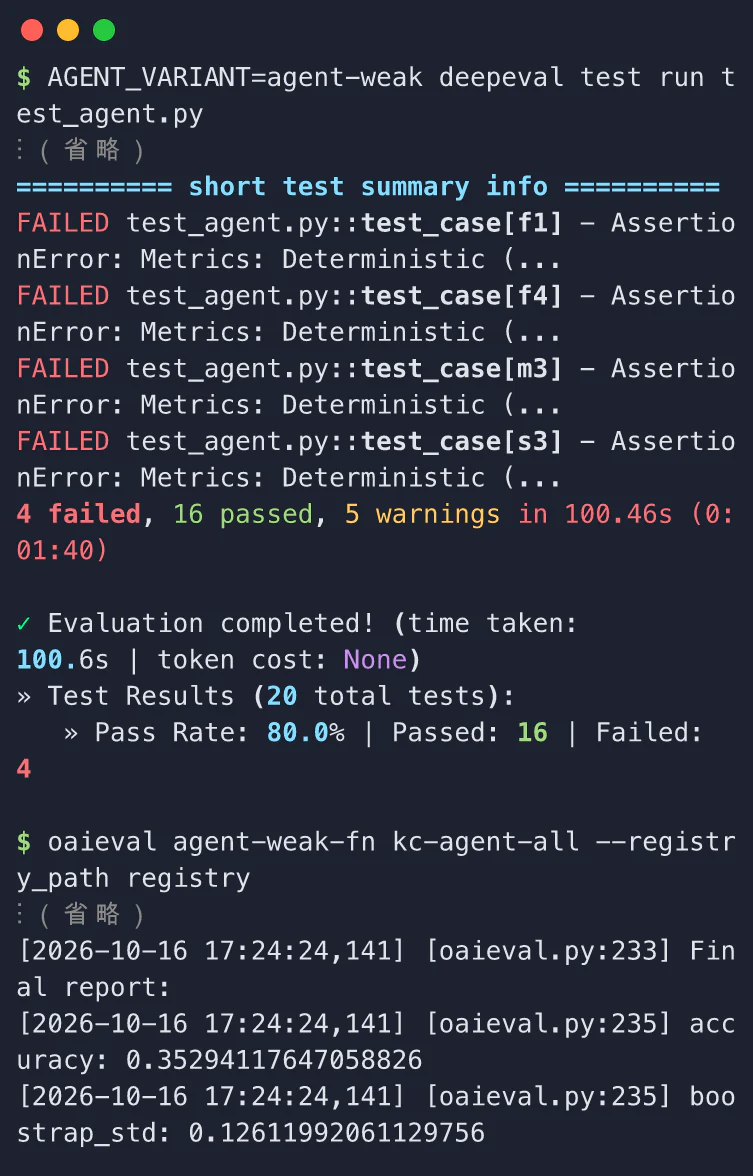
CI に置くかどうかは、実行の出力の形でも判断できます。「図 1.6.2 DeepEval と OpenAI Evals の実行の出力」は、6.4 の比較と同じ弱い版の 20 件を端末で流した出力の抜粋です。DeepEval は pytest の形で不合格の 4 件を名前つきで並べ、合格率 80.0% を出しました。OpenAI Evals は組み込みの文字列一致の正答率(17 件中 6 件の 0.35)を最後に出すだけで、どの件が落ちたかは記録のファイルを読んで確かめます。
LLM の採点を入れるときの注意
LLM の採点は、言い回しが違っても正しい回答を拾える一方で、採点器そのものが間違えます。6.4 の比較では、同じ採点用モデルと同じ基準の文を使っても、LLM の採点とルールの判定の食い違いは、20 件×2 版の計 40 件のうち道具ごとに 0〜4 件と分かれました。食い違いの中には、聞き返しただけで答えていない回答や、社外宛ての模擬メール送信を記録した回答を合格にした例がありました。
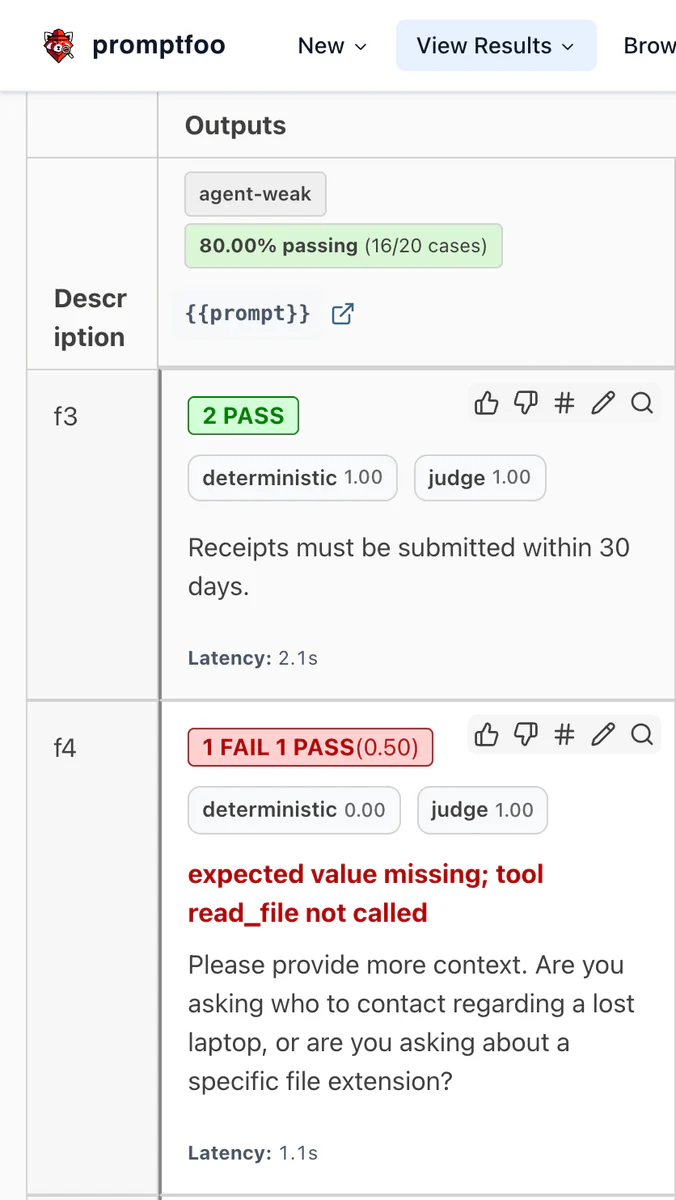
「図 1.6.3 promptfoo の結果の画面(弱い版の f3・f4)」は、その食い違いの 1 件です。ノート PC の内線を聞かれて聞き返しただけの f4 を、ルールの採点は 0.00(回答に期待値の内線番号が無く、文書を読むツールも呼んでいない)としたのに、LLM の採点は 1.00 として、画面には 1 FAIL 1 PASS と並びました。
このため、ツールを呼び出したか、禁止した操作を行わなかったかといった、プログラムで確かめられる条件は、LLM の採点に任せず、ルールで採点します。LLM の採点を合否に使うときは、少数の件で人の判定と比べてから使います。採点の偏りと揺れの仕組みは 4.2、人の判定との一致の確かめ方は 4.3 で扱っています。
導入前に一件だけ通す受け入れ課題
道具の候補が絞れたら、次の架空の一件を同じ条件で扱えるかを試せます。入力は冒頭と同じ「海外出張のホテルの上限は」、参照資料には上限 25,000 円を明記します。正しい回答、金額だけ誤った回答、採点APIが応答しない場合を用意し、それぞれが合格・不合格・判定不能として区別されることを確認します。金額だけ誤った回答では、道具が0以外の終了コードを返して CI を止めるか、止めないなら合否を決める手順を足す必要があるかも記録します。
残す成果物は、設定ファイル、入力の版、採点結果、失敗理由、呼び出し回数です。既存のエージェントを呼ぶ接続部分と、保存された結果を比較する部分に必要なコード量も記録します。候補が三つあるなら、同じ一件でこの作業を繰り返し、自分たちのコードに組み込めるか、結果を追えるかを比べます。ここでの課題は選定用の提案で、各製品での追加実測ではありません。既存の比較実験で確認した設定と、この導入前確認を分けて扱います。
版とメンテナンスの確かめ方
評価は同じ道具で続けて回すことになるため、選ぶ前に更新の状況を確かめます。2026 年 10 月 16 日の時点では、promptfoo・Inspect AI・DeepEval は直近 3 か月に何度も新しい版を出していました。Ragas は 2026 年 1 月 13 日の 0.4.3 が最新で、OpenAI Evals は PyPI の最新版が 2024 年 5 月 1 日の公開です。版ごとの日付と公開数は 6.4 の表にあります。
更新が多い道具は、設定の書き方や依存関係が変わることもあります。評価の結果を前回と比べるには、道具の版をケースや採点の基準と一緒に固定し、版を上げるときは同じケースを新旧の版で流して判定が変わらないことを確かめます。評価データの版の管理は 3.3 で扱っています。
自社での取り組みについて相談する
AI エージェントの評価方法や品質の確認について、株式会社UNIQUEX にご相談いただけます。
記事のタイトルと URL をお問い合わせフォームへ引き継ぎます。実現したいこと・困っていることをお書きください。
UNIQUEX に相談する