LLM 採点を含む評価の実行時間の短縮
promptfoo 0.124.1 で 2 件 × 採点 10 項目の評価を流し、採点の同時実行を決める 3 つの上限と採点モデルの思考を変えて、所要時間と、採点モデルが受けた同時実行の数を測った記録です。
要点
- promptfoo 0.124.1 で LLM 採点を -j 2 で流すと、採点モデルが受ける同時実行数は 2 本にとどまり、1 件の中の採点の並列数を 10 に上げても変わりませんでした。
- 採点を 20 本同時に送れたのは、adaptive scheduler の停止、1 件の中の採点の並列数を 10 に設定、HTTP の接続の数(PROMPTFOO_FETCH_CONNECTIONS)を 20 に設定という、3 つの条件をそろえたときだけで、gemini-2.5-flash-lite での採点 20 回の所要時間が 9.2 秒から 2.1 秒になりました。
- promptfoo 0.121.19 は --env-file の .env から採点の並列数を読まず、0.124.1 は読みました。
- 思考が既定で有効な gemini-2.5-flash は、思考を止めると採点 1 回の時間が 1,596 ms から 917 ms になり、出力の上限を 256 にした回では思考ありの採点 20 回のうち 7 回が途中で切れて、2 件とも不合格になりました。
- 数値は合成データ(評価ケース 2 件 × 採点項目 10 件)を手元で流した値で、実際の評価の規模や採点モデルにそのまま当てはまるとは限りません。
定義
- LLM 採点
- 採点用の言語モデルに、回答と基準の文を渡して合否を判定させる採点です。promptfoo では llm-rubric がこれに当たります。
- adaptive scheduler
- promptfoo 0.124.1 の、提供元(provider)ごとに同時実行の数を管理し、429 などの上限の応答で数を下げる仕組みです。上限は --max-concurrency(-j)の値です。
- 思考
- 採点モデルが答えの前に内部で推論に使う出力です。Gemini と Claude では、思考のトークンも出力の上限と出力の料金に数えられます。
LLM 採点(採点用の言語モデルに回答と基準の文を渡して合否を判定させる採点)を CI で毎回流すと、評価の時間の大半が採点の待ち時間になることがあります。この記録では、promptfoo 0.124.1 で、採点が何本同時に送られるかを決める設定と、採点モデルの思考の有無を変えて、所要時間と、採点モデルの側で受けた同時実行の数を測りました。
費用と時間をどう測り、成功率とどう並べて読むかは 5.4 に、評価をどこで動かすか(隔離や外部依存)は 6.3 にあります。この記録は「同じ評価を、結果を変えずに短く終わらせる」ことだけを扱います。
検証の条件
データは合成で、評価ケースは 2 件、各ケースに llm-rubric の採点項目を 10 件付けました(採点の呼び出しは 1 回の実行で 20 回)。エージェントは、架空の会社の経費精算の規程について決まった回答を返す検証用の模擬モデルで、0.5 秒で応答します。
採点モデルの側には検証用のサーバー(server.mjs)を置き、受けた要求の数を数えました。promptfoo の内部の数ではなく、採点モデルから見た同時実行の最大(いちばん多く重なった要求の数)を記録しています。エージェントと採点モデルは、実際の構成に合わせて別の port(別の接続先)にしました。
| 採点モデル | 内容 | 費用 |
|---|---|---|
| 偽物 | 1 回 1 秒待って合格の JSON を返す | 0 |
| gemini-2.5-flash-lite | 思考なし(既定)、温度 0 | 有料枠 |
| gemini-2.5-flash | 思考あり(既定)と、reasoning_effort: none で思考を止めた版。温度 0、出力の上限 4,096 と 256 | 有料枠 |
Gemini は OpenAI 互換 API を、server.mjs を経由して呼びました。API の鍵はこのサーバーだけが持ち、promptfoo の設定には書いていません。採点 1 回の入力は約 650 トークンです。並列数の測定は 3 回くり返し、中央値を載せました。
手順
- 模擬の採点モデルで、
-j(--max-concurrency)と 3 つの環境変数の組み合わせを順に流す(run-fake.sh)。 - 同じ 3 つの環境変数を
--env-fileの.envとシェルの環境変数で渡し、promptfoo 0.121.19 と 0.124.1 を比べる(run-envfile.sh)。 - 採点モデルを gemini-2.5-flash-lite にして、1 の主な組み合わせを流す(
run-gemini.sh)。 - gemini-2.5-flash で、思考ありと思考なしを、出力の上限 4,096 と 256 で流す(
run-gemini.sh)。 summarize.mjsで中央値の表を、cost.mjsで費用を出す。
変えた設定は次の 4 つです。
| 設定 | 何を決めるか | 既定 |
|---|---|---|
-j(--max-concurrency) | 同時に流す評価ケースの数。0.124.1 では提供元ごとの同時実行の上限(adaptive scheduler)にも、0.121.19 と 0.124.1 では HTTP の接続の数の既定にも使われる | 4 |
PROMPTFOO_DISABLE_ADAPTIVE_SCHEDULER | adaptive scheduler を止める | false |
PROMPTFOO_ASSERTIONS_MAX_CONCURRENCY | 1 件の中で同時に走らせる採点の数 | 3 |
PROMPTFOO_FETCH_CONNECTIONS | promptfoo の HTTP の接続の数(接続先ごと) | -j の値 |
adaptive scheduler は、提供元(provider)ごとに同時実行を管理し、429 などの上限の応答で数を減らす仕組みで、上限は -j です(Promptfoo、Rate Limits)。0.124.1 のソースでは、評価の開始時に -j の値(既定 4)でこの上限を作り(evaluator.ts L3604–3607)、環境変数で止められます(rateLimitRegistry.ts L41)。1 件の中の採点の並列数は実行時に環境変数から読みます(assertions/index.ts L825–832)。HTTP の接続の数は、PROMPTFOO_FETCH_CONNECTIONS が無ければ -j の値です(fetch/index.ts L68–84)。
並列数の設定ごとの結果
模擬の採点モデル(1 回 1 秒)で、最初の要求から最後の応答までを測った結果です。採点 20 回が 1 本ずつなら約 21 秒、20 本同時なら約 2 秒になる条件です。
| 設定(どれも -j 2。違うものだけ書く) | 秒 | 採点の同時実行の最大 |
|---|---|---|
| -j 1 | 21.2 | 1 |
| 既定 | 11.0 | 2 |
| 採点の並列数 10 | 11.0 | 2 |
| -j 10 | 5.0 | 6 |
| scheduler を止める | 11.0 | 2 |
| scheduler を止める + 採点の並列数 10 | 11.0 | 2 |
| 採点の並列数 10 + 接続 20 | 11.0 | 2 |
| scheduler を止める + 接続 20 | 5.0 | 6 |
| scheduler を止める + 採点の並列数 10 + 接続 20 | 2.0 | 20 |
既定では、1 件の中で 3 本まで採点を走らせる設定があっても、採点モデルが受けた同時実行数は 2 本でした。-j 2のままで2本を超えたのは、scheduler と HTTP の接続の 2 つの上限を外したときで、そのとき初めて 1 件の中の採点の並列数(既定 3、2 件で 6 本)が効きました。3 つをそろえると 20 本が同時に送られ、11.0 秒が 2.0 秒になりました。-j 2のままではschedulerまたは接続の上限が残れば2本、両方を外して採点の並列数が既定3なら6本です。scheduler を止めたときに同時に送られる採点は最大で -j × 採点の並列数なので、PROMPTFOO_FETCH_CONNECTIONS はその積以上にします(足りないと、接続の数が同時実行の上限になります)。
-j 10 でも採点は 6 本まで重なり、5.0 秒でした。ただし -j はエージェントへの同時実行の上限も 10 に上げます。この記録ではケースが 2 件しかないのでエージェントへの同時実行は 2 本でしたが、ケースが多い評価では、エージェントやその先のサービスに -j 本の要求が同時に届きます。-j 1 では、0.124.1 は採点を提供元ごとにまとめて 1 本ずつ流します(evaluator.ts L5347–5348)。
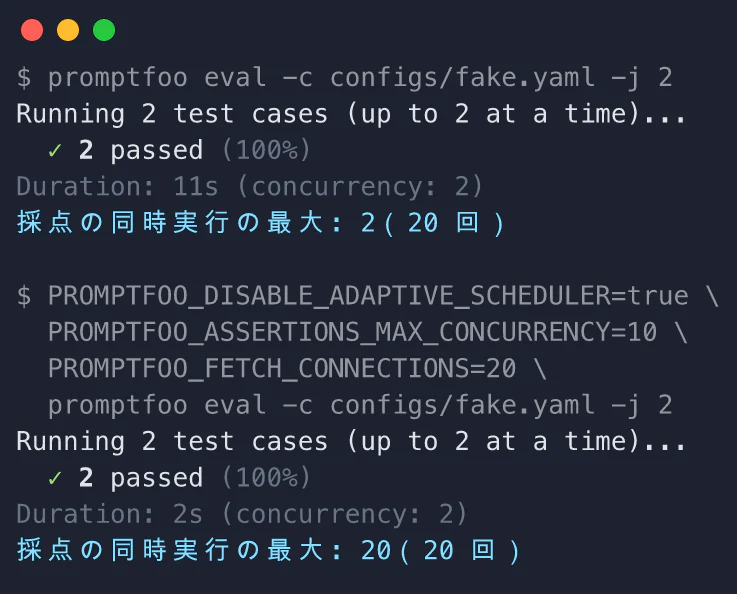
図 6.5.1 3 つの上限を外す前と後の promptfoo の実行は、既定の実行と、3 つの上限を外した実行を並べた端末の画面です。promptfoo が出す Duration は 11 秒から 2 秒に縮み、採点モデルの側で数えた同時実行の最大は 2 から 20 に増えました。合否はどちらも 2 件とも合格で変わりません。
本物の採点モデル(gemini-2.5-flash-lite、採点 1 回の中央値 0.8 秒)でも同じ形でした。
| 設定(-j 2) | 秒 | 採点の同時実行の最大 |
|---|---|---|
| 既定 | 9.2 | 2 |
| -j 10 | 4.3 | 6 |
| scheduler を止める + 採点の並列数 10 | 9.5 | 2 |
| scheduler を止める + 採点の並列数 10 + 接続 20 | 2.1 | 20 |
3 回とも合否は同じ(2 件とも合格)で、429 などの上限の応答は 1 回もありませんでした。
ひし形は三つの制限を順に調べる分岐です。途中で抜ける枝は制限が残る設定、最下段まで進む枝はすべて解除した設定に対応します。表の結果と設定の組み合わせを、経路としてたどれます(図 6.5.3 採点の同時実行を決める3つの上限)。
環境変数の渡し方による違い
3 つの環境変数を --env-file で渡す .env に書いた場合と、シェルの環境変数で渡した場合を、2 つの版で比べました(模擬の採点モデル、-j 2)。
| 版 | 渡し方 | 秒 | 採点の同時実行の最大 |
|---|---|---|---|
| 0.124.1 | .env(--env-file) | 2.0 | 20 |
| 0.121.19 | .env(--env-file) | 5.0 | 6 |
| 0.124.1 | シェルの環境変数 | 2.0 | 20 |
| 0.121.19 | シェルの環境変数 | 2.0 | 20 |
0.121.19 で .env から渡すと、scheduler の停止と接続の数は効いた(2 本を超えた)一方、採点の並列数は既定の 3 のまま(2 件で 6 本)でした。0.121.19 は採点の並列数をモジュールの読み込み時に読む定数にしていて(0.121.19 の assertions/index.ts L114)、--env-file の読み込みより先に値が決まります。0.124.0 の修正(#11059)で、実行時に読むように変わりました。0.124.0 より前の版では、採点の並列数はシェルの環境変数で渡すと確実です。
採点モデルの思考を止めた結果
gemini-2.5-flash は、既定で思考(答えの前に内部で推論に使う出力)が有効です(Gemini thinking)。OpenAI 互換 API では、2.5 系は reasoning_effort を none にすると思考を止められます(Gemini API、OpenAI compatibility)。promptfoo の設定では passthrough で渡しました。
| 採点モデルの設定 | 採点 1 回(中央値) | 出力トークン | 思考トークン | 全体の秒(-j 2) | 出力の上限で切れた回 |
|---|---|---|---|---|---|
| 思考あり、上限 4,096 | 1,596 ms | 62 | 134 | 18.8 | 0/60 |
| 思考なし、上限 4,096 | 917 ms | 47 | 0 | 10.3 | 0/60 |
| 思考あり、上限 256 | 1,610 ms | 48 | 164 | 16.8 | 7/20 |
| 思考なし、上限 256 | 896 ms | 47 | 0 | 10.4 | 0/20 |
思考を止めると採点 1 回の時間が約 1.7 分の 1 になり、合否は思考ありと同じ(上限 4,096 では 3 回とも 2 件とも合格)でした。採点の内容は「回答が基準を満たすか」を短い JSON で返すだけで、この記録の 20 項目では思考が判定を変えませんでした。採点が難しい基準でも同じとは限らないので、思考を止める前後で判定の一致を確かめます(4.2)。
Gemini の思考のトークンは、OpenAI 互換 API の応答では completion_tokens に含まれず、total_tokens にだけ含まれていました(入力トークンと出力トークンを引いた残りを思考トークンとして数えた)。最大出力トークンは思考を含み(Gemini thinking)、出力の料金も思考を含みます(Gemini API pricing)。
つまずき
出力の上限を思考が使い切り、採点結果が読めなくなった。 gemini-2.5-flash の出力の上限を 256 にすると、思考ありの採点 20 回のうち 7 回(撮影のために再実行した回では 6 回)が上限で終わり(finish_reason: length)、promptfoo は Could not extract JSON from llm-rubric response で不合格にしました。エージェントの回答は同じなのに、2 件とも不合格です。思考なしでは 256 でも 1 回も切れませんでした。
画面は横にスクロールできます(押すと実寸で開きます)
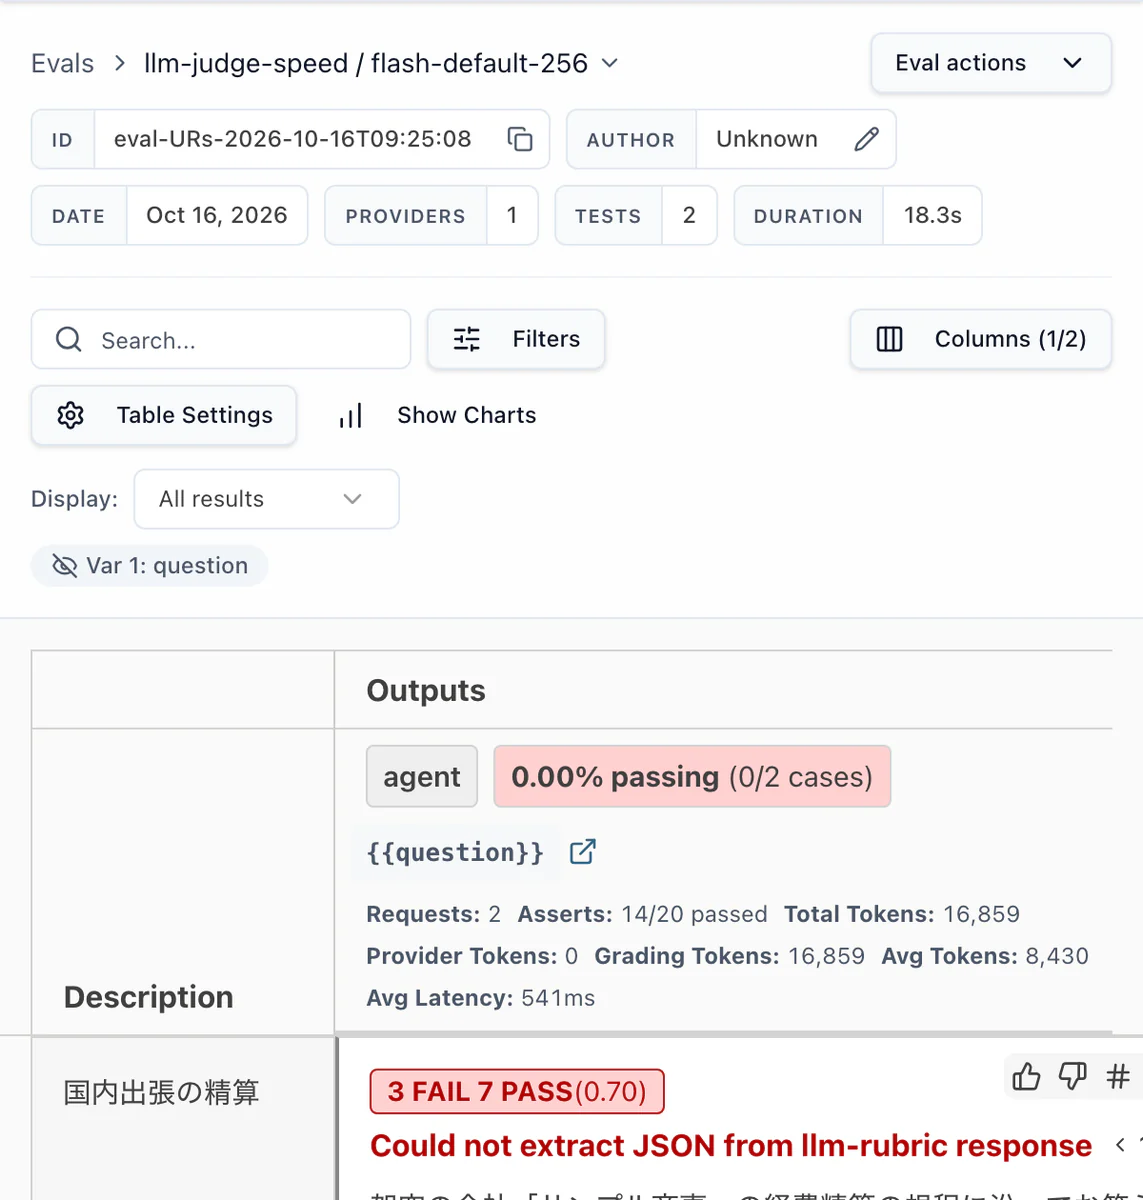
図 6.5.2 思考で出力の上限を使い切った採点の結果は、その回の promptfoo view の画面です。採点 20 回のうち 6 回が不合格(Asserts 14/20 passed)で、2 件とも 3 FAIL 7 PASS、不合格の理由はどれも JSON を読めなかったことでした。エージェントの不具合ではなく採点の失敗なので、思考を有効にしたまま使う採点モデルでは、出力の上限を思考に必要な分まで確保します。Claude の公式文書も、思考は max_tokens に含まれ、思考なしの応答に合わせた上限では足りなくなることがあると説明しています(Anthropic、Steering thinking)。
同時実行を上げても 2 本で止まった。 最初は、scheduler を止めて採点の並列数を 10 にすれば足りると考えましたが、採点モデルが受けた同時実行数は 2 本のままでした。原因は、promptfoo の HTTP の接続の数が接続先ごとに -j の値(ここでは 2)になることで、PROMPTFOO_FETCH_CONNECTIONS を上げるまで変わりませんでした(fetch/index.ts L103–117)。この変数は CHANGELOG とソースにはありますが、Rate Limits と Command line のページには載っていません(2026-10-16 時点)。
1 回の遅い応答が全体を決めた。 gemini-2.5-flash-lite の -j 10 の 3 回目は、20 回の採点のうち 1 回だけ応答に 106.8 秒かかり、実行全体が 108 秒になりました(ほかの2回の実行全体、つまり最初の要求から最後の応答までは4.147秒と4.350秒)。並列数を上げても、いちばん遅い 1 回の応答時間より短くはなりません。CI では提供元の時間切れ(timeout)を短めに決め、再試行の回数と合わせて上限の時間を見積もります。
scheduler を止めると、自動の減速が無くなる。 adaptive scheduler は 429 の応答で同時実行を半分にし、retry-after の待ち時間を守ります(Promptfoo、Rate Limits)。止めた場合はこの減速が働かず、提供元のクライアントや HTTP の層の再試行だけになります。この記録では 429 は起きていません。採点モデルの利用上限(1 分あたりの要求数やトークンの数)に近い評価では、採点の並列数を上限から逆算して決めます。
別の担当の計測との違い
UNIQUEX の別の担当が、同じ形の合成データ(評価ケース 2 件 × 採点項目 10 件)を、Amazon Bedrock の Claude Sonnet 5 を採点モデルにして手元で測った値があります。実案件の成果ではなく、合成データの値です。版・反復数などの詳細は未確認で、同じ条件にそろえた性能比較ではありません。
| 設定(-j 2) | 別の担当の計測(Bedrock、Claude Sonnet 5) | この記録(gemini-2.5-flash-lite) |
|---|---|---|
| 既定 | 41.0 秒 | 9.2 秒 |
| 採点の並列数 10 | 35.8 秒 | 未測定(偽物では 2 本で止まった) |
| -j 10 | 12.8 秒 | 4.3 秒 |
| scheduler を止める + 採点の並列数 3 | 14.7 秒 | 未測定(偽物では 2 本で止まった) |
| scheduler を止める + 採点の並列数 10 | 8.0 秒 | 9.5 秒(2 本で止まった) |
大きく違うのは、scheduler を止めて採点の並列数を上げた行です。別の担当の計測ではそれだけで速くなり、この記録では HTTP の接続の数も上げるまで、同時実行は 2 本にとどまりました。promptfoo の Bedrock の提供元は AWS の SDK(BedrockRuntime)と専用の要求の処理を使い、この記録で使った OpenAI 互換の提供元は promptfoo の HTTP の接続を使います。そのため Bedrock では接続の数の上限が効かなかったと推定していますが、この検証ではBedrockを動かしておらず、その理由は確かめていません。同じ設定でも、使う提供元の種類で効き方が変わります。
UNIQUEX の別の担当が、合成データで接続の数だけを変えて測った値(-j 2、scheduler を止める + 採点の並列数 10)は次のとおりです。
| 採点モデル(別の担当の計測) | 接続 2(既定) | 接続 20 |
|---|---|---|
| Gemma 4 26B(Bedrock の OpenAI 互換の口) | 12.6 秒 | 4.4 秒 |
| Claude Sonnet 5(Bedrock、AWS の SDK) | —(未測定) | 9.1 秒 |
— の欄は、既定の値をこの追試では測っていないことを示します。
Claude を採点モデルにするときの設定(未確認)
Claude による採点は実行しておらず、以下の説明は別の担当の計測と公式文書に基づきます。
- 別の担当の計測では、Claude Sonnet 5 は思考を指定しないと思考を使い、
thinking: {type: disabled}で採点の時間が 13.2 秒から 6.7 秒(この計測の並列設定など詳細は未確認)(出力は 1 回あたり約 195 から約 110 トークン)になりました。Claude では思考はmax_tokensに含まれます(Anthropic、Steering thinking)。思考を止めないなら、上限を思考の分まで空けます。 - 思考の量は
output_config.effortで調整し、段階はlow・medium・high・xhigh・maxで、Claude Sonnet 5 の既定はhighです(Anthropic、Effort)。noneという段階はありません。 - promptfoo 0.124.1 の
bedrock:の提供元(InvokeModel の経路)は effort の欄を持たず、送りません(bedrock/index.ts L1658–1660)。別の担当の計測では、思考を止めた短い JSON の採点に effort のlowを足しても、出力が約 2 割減っただけで時間はほぼ同じでした。Bedrock の地域ごとの提供や Converse の経路の違いは、この記録では確かめていません。
自分の評価で設定を戻す条件を決める
この記録の2件×10項目を、そのまま大規模な評価へ外挿しないでください。例えば100件×10項目なら採点要求は1,000回です。仮に毎分60要求を上限とする試験条件なら、全要求を処理するには約16.7分相当の送信枠が必要です。これは架空の容量計算で、提供元の実際の上限や所要時間の保証ではありません。採点1回の時間を、この記録の gemini-2.5-flash-lite の中央値0.8秒で一定と仮定すると、同時実行c本で待ち時間なしで送る単純計算は毎分c×60÷0.8=75c件です。毎分60要求ならc=1でも過剰なので、必要なのは同時実行数の引き上げではなく送信間隔の制御です。短時間に集中した送信、トークン上限、再試行によって待ちは増えます。
設定を変える際は、同じ回答と基準を使い、まず少量で既定設定と比較します。記録するのは promptfoo の版、-j と3つの環境変数の値と渡し方(シェルか--env-fileか)、全体時間、採点の同時実行最大、429、時間切れ、JSONを読めなかった数、合否が変わった項目です。速くても採点不能が増えた設定は採用せず、並列数や接続数を戻します。思考を止める変更では、速度と判定の一致を別に点検します。この記事の「429が0件」は測った条件の結果であり、大きな評価でschedulerを止めてよいという保証にはなりません。
ほかに効く手
この記録では測っていませんが、promptfoo の機能で採点の時間を減らせるものです。
- 結果が決まった判定(文字列を含むか、JSON の形か)は、
containsなどのルールの採点にし、LLM 採点を減らす(4.1)。 - 採点項目ごとに
providerを指定し、簡単な基準による採点だけを、速い採点モデルに任せる。 - 前回落ちたケースだけを流す(
--filter-failing)、評価ケースを番号の範囲(--filter-range)で分けて別の CI の job で並べて流す(Promptfoo、Command line)。 - CI では毎回新しい環境で動かすため、promptfoo の結果の cache はほとんど当たりません。cache を前提に時間を見積もらないようにします(6.3)。
自社での取り組みについて相談する
AI エージェントの評価方法や品質の確認について、株式会社UNIQUEX にご相談いただけます。
記事のタイトルと URL をお問い合わせフォームへ引き継ぎます。実現したいこと・困っていることをお書きください。
UNIQUEX に相談する